01真实采样
多平台,按真实问法采样
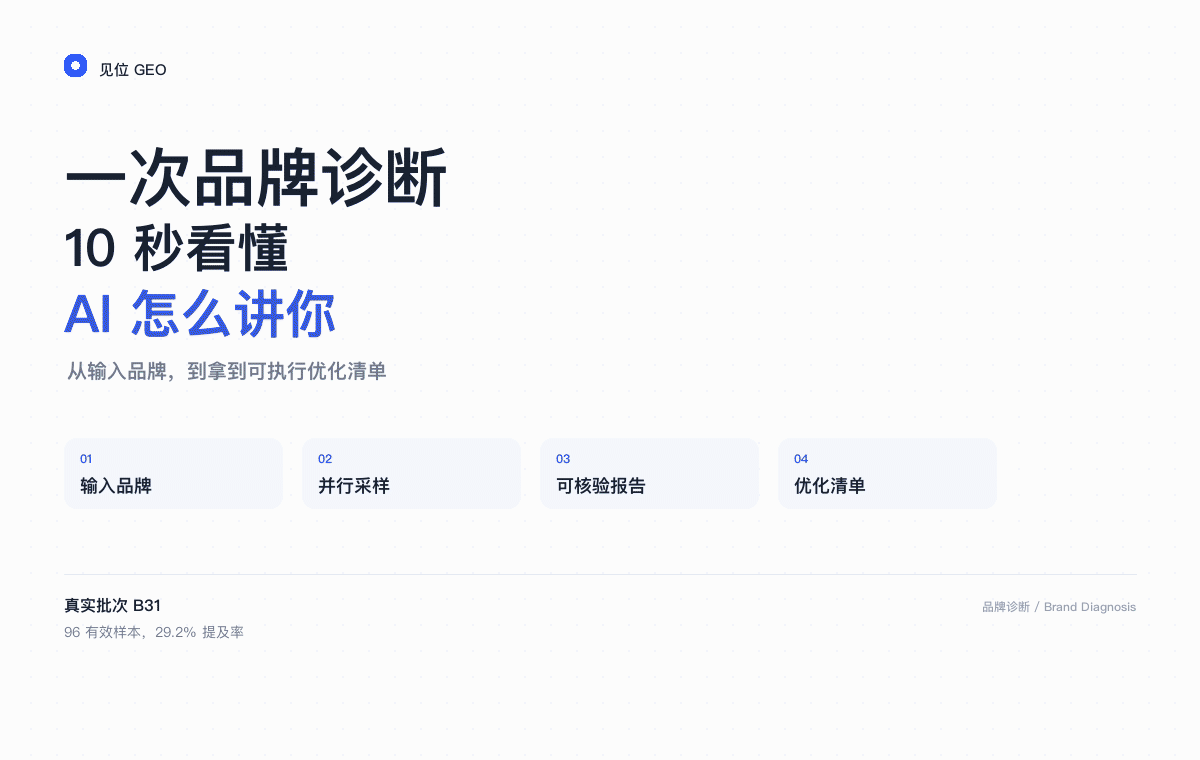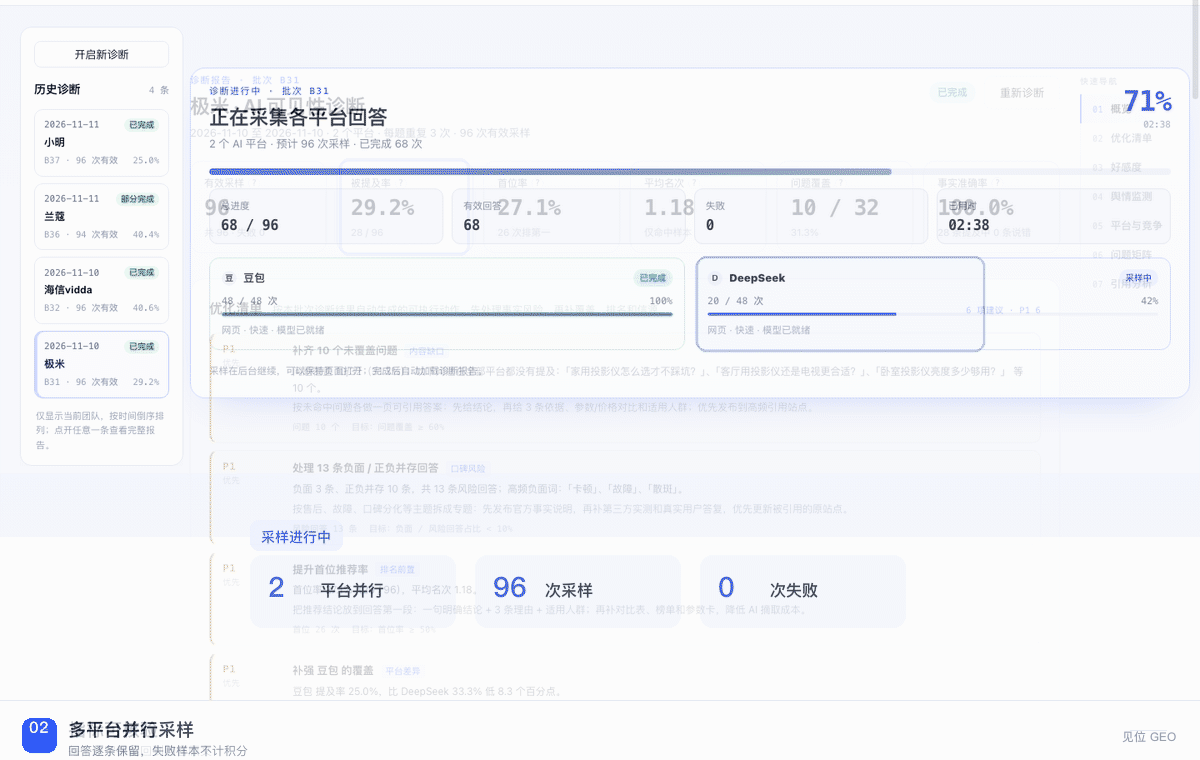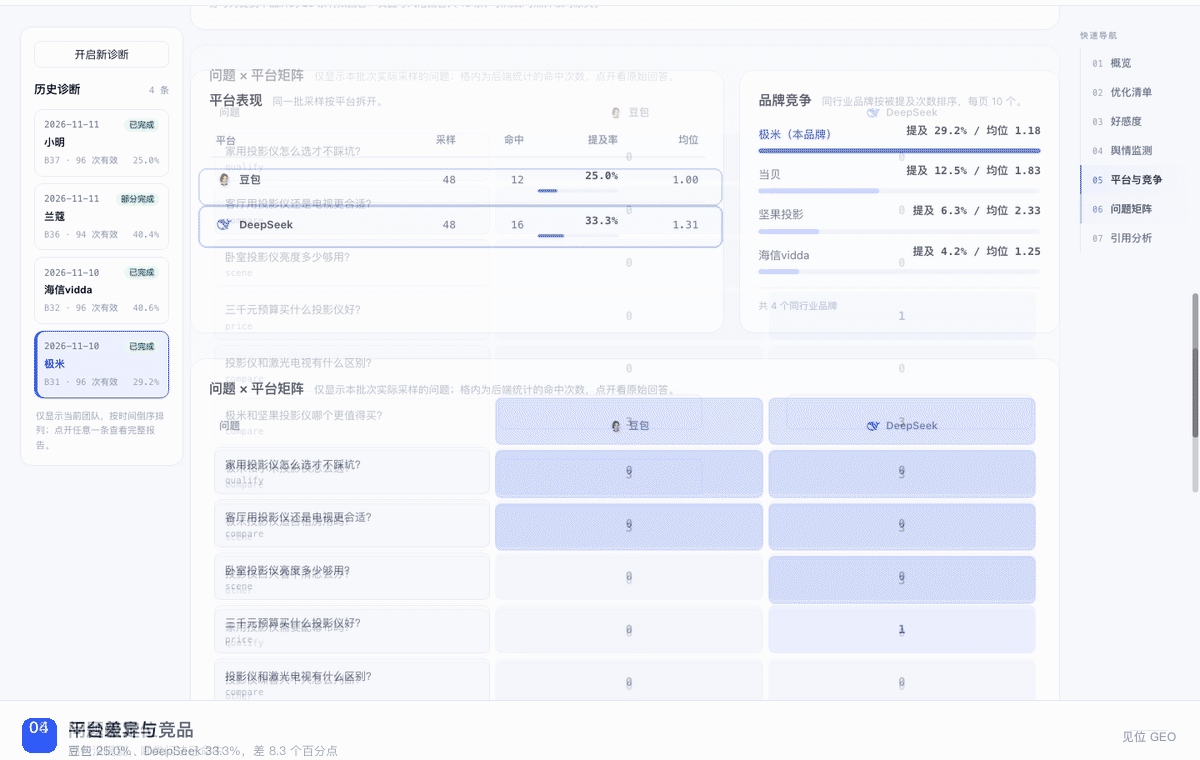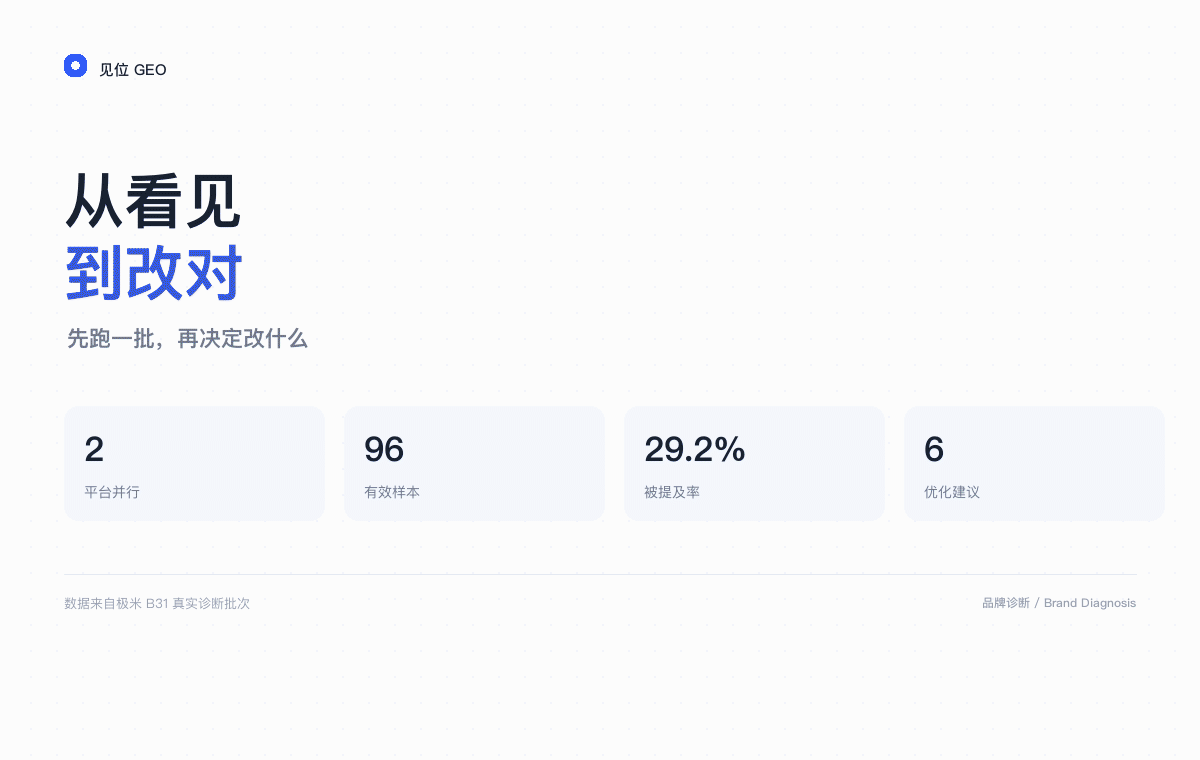
覆盖主流 AI 平台。同一问题重复提问,保留回答原文、名次、耗时与引用。
在豆包、DeepSeek、千问等平台,用真实问法重复提问。看清品牌有没有被提到、排第几、说得对不对,再按报告改内容。
平台能力
真实采样、品牌与商品诊断、问题级归因和持续监测。四个能力共用同一批回答,报告里的每个数字都能回到原文。
01真实采样
覆盖主流 AI 平台。同一问题重复提问,保留回答原文、名次、耗时与引用。
02双线诊断
品牌看提及率、首位率、事实准确率和问题覆盖;商品看商品卡、价格和排名。不重复采样。
03问题级归因
问题与平台矩阵展开每个数字,同行业竞品按提及排序,报告直接给出可执行的优化清单。
04持续监测
首轮结果作为基线,按天或周复跑;指标跌破阈值告警,复测确认改动是否生效。
GEO 案例
从真实品牌库里的行业品牌出发,拆开消费者在 AI 里的典型问法。案例给的是优化切口,具体指标以每批诊断结果为准。
典型问法千元投影仪怎么选?亮度、分辨率和噪音怎么平衡?
优化切口补齐型号参数、亮度实测、噪音和真实场景样张,让 AI 有可引用的对比依据。
典型问法抗老精华怎么挑?成分、肤质和价格带怎么比较?
优化切口补齐成分浓度、适用肤质和价格带证据,避免 AI 只复述品牌广告。
典型问法空调怎么选更省电?能效、噪音和售后怎么权衡?
优化切口把能效、噪音、安装成本和售后范围做成可检索的对比页。
典型问法日常饮用水怎么选?水源、标准和口感哪个更重要?
优化切口补齐水源地、执行标准和饮用场景内容,让答案优先引用品牌自有页面。
典型问法纸尿裤怎么选不红屁屁?尺码、透气和敏感肌怎么判断?
优化切口补齐尺码、透气性、敏感肌测试和真实评价,降低事实错误与负面引用。
典型问法跑鞋怎么选?缓震、支撑和适用场景怎么匹配?
优化切口补齐缓震、支撑、适用场景和价格带,让产品进入选购类问题的候选清单。
行业示例,用于说明 GEO 优化切口;案例指标以真实诊断批次为准。
不承诺排名,只把 AI 当前怎么讲你这件事说清楚。
只问一次、只调用一个平台。不重复采样,不计算提及率与首位率,直接展示回答原文、引用和结构化分析。
只选一个平台,点另一个平台会替换当前选择;卡内再选网页/手机与快速/深度。
本次回答
选好品牌与平台,按所选平台 × 当前品牌题库 × 每题 3 次采样跑一轮。
点品牌卡选中平台;卡内再选网页/手机与快速/深度,未接平台的选项置灰。
诊断进行中 · 批次 —
正在排队,准备采样任务…
采样在后台继续,可以保持页面打开;完成后自动加载诊断报告。
诊断报告 · 批次
—
按本批次诊断结果自动生成的可执行动作,先处理事实风险,再补覆盖、排名和信源。
—P0 事实与风险先修,P1 影响增长,P2 属维护项;完成后用同一问题集复测验证。
AI 提到本品牌时说的是正面、中性还是负面;同一条回答里正负评价都有,归为「正负并存」。
—只统计提到本品牌的有效回答,未提及样本不计入分母。
从提到本品牌的回答中抽取正负评价词,并保留负面 / 正负并存回答及其引用源。
—评价词只从提到本品牌的有效回答中抽取;负面与风险回答包含纯负面和正负并存。
同一批采样按平台拆开。
同行业品牌按被提及次数排序,每页 10 个。
格内数字为 3 次采样中的命中次数,点开看原始回答。
AI 引用的文章有多新,按发布时间分布。
—AI 回答引用了哪些站点、引用了多少次。
每条引用保留标题、原文片段和可打开的来源链接。
商品层看两件事:正文有没有写到型号,回答里的商品卡有没有你。
商品诊断只取网页场景;卡内选择快速 / 深度模式,未接平台的选项置灰。
商品诊断进行中 · 批次 —
正在排队,准备采样任务…
采样在后台继续,可以保持页面打开;完成后自动加载诊断报告。
商品报告 · 批次
—
按商品批次的型号命中、商品卡和引用结果生成的可执行动作。
—先修事实与卡片缺口,再补首位率、信源和引用时效;完成后用同一问题集复测。
同一批采样按平台拆开,正文命中与商品卡分开看。
卡有没有出现、出现几次、自有占多少。
按回答里的商品卡统计自有与竞品、卡位和商城来源。
同一张卡按出现次数排序;自有与竞品分开标记,品牌变体名先合并再计数。
同一张卡按自有商品与竞品分开计数。
卡在回答商品列表中的位置,1 为最靠前。
共 0 条商品卡,其中自有 0 条。数据来源:平台原生卡,与「正文提到型号」分开统计。
格内数字为 3 次采样中的命中次数,点开看原始回答。
AI 回答引用了哪些站点、引用了多少次。
每条引用保留标题、原文片段和可打开的来源链接。
AI 引用的文章有多新,按发布时间分布。
—正在读取监测计划…
套餐限制
升级到基础版后可创建 1 个监测计划,按固定问题与平台持续观察 AI 可见度。
按固定问题与平台重复跑,口径不变才可比。
新建监测计划
先补品牌信息,下一步会自动生成一套 AI 问题。
Step 1 / 3
这些信息只用于生成问题和识别提及,监测计划会挂在当前团队下。
品牌词用于识别 AI 回答里的提及,建议把简称、英文名、常见误写一起填上。
Step 2 / 3
根据品牌名称、官网和介绍生成,尽量模拟真实买家的提问。
监测会按所选平台逐题采样;未接凭证的平台暂不可选。
至少选择一个平台,之后每轮会按同样配置重复采样。
Step 3 / 3
会先保存计划与下一次执行时间,之后按同样口径重复跑。
启动后计划状态变为运行中;首轮按上面设置的时间执行。
每轮沿用同一套问题与平台,口径不变才可比。
超过阈值才写一条,不刷屏。
额度清晰 · 即买即用 · 7 个平台任选 · 失败与未完成采样不扣积分
四档套餐都跑同一套采样口径:每问每平台重复 3 次,命中、说错、未提及分开记,每条结论都能点开原始对话与引用核对。需要人替你读数、定动作、写报告,可以先用专业版跑起来。
套餐积分按采样次数抵扣。一次品牌诊断按 16 个问题、4 个平台估算 = 192 次采样(只接 2 个平台时按 96 次计),先扣套餐积分,超出部分按 0.02 元/次结算。商品诊断按 3 个问题 × 平台 × 3 次计,规模小得多。
监测是复购的地基。我们把监测计划跟着套餐档位递增:基础版 1 个、专业版 3 个、旗舰版 5 个;体验版先不含监测,适合先跑一次诊断验证效果。
不是每个平台都支持三种场景:豆包、千问、元宝支持网页与手机;DeepSeek 支持网页与手机快速档;Kimi、文心、百度 AI 目前只有网页;电商场景目前只开放豆包。同一平台的网页与手机会分开统计,不合并计算。
每条结论都可以展开对应问题 × 平台的全部采样记录,查看平台、时间、命中/说错/未提及、整段回答原文与引用来源。基础版起可导出 PDF,专业版起增加 Excel 与 API,旗舰版再增加 Markdown。
不算。失败与未完成不进分母、也不扣积分;被拒答或与问题无关的回答同样剔除。页面上的提及率分母只算有效回答,所以每档套餐的可用额度不会被失败请求吃掉。
价格含平台调用成本;超出套餐的采样按 0.02 元/次计。企业内网部署与 OEM 另议。
OPEN PLATFORM
面向企业系统、代理商与内容平台开放诊断、引用和监测数据。用同一套采样口径,把分散在各家 AI 回答里的品牌表现,变成可以入库、可以告警、可以二次分析的结构化结果。
开放平台内测中 · 按应用审核开通
能力示意,正式字段以接入文档为准
CAPABILITIES
不必自己维护各平台账号和解析规则,按任务提交,按结果回传。
提交品牌、问题集与目标平台,异步返回批次状态、有效样本和品牌提及结果。
拿到回答原文、引用 URL、站点信息,以及品牌提及、首位、竞品与好感度标签。
把问题集按计划持续跑,结果变化通过 Webhook 推回你的系统,不用反复导出。
ACCESS
从一次性诊断到持续监测,都可以只取需要的字段;历史批次保留原始回答与引用,便于复核和二次建模。
ONBOARDING
说明使用场景、调用量与需要的能力。
确认资质与套餐,创建应用和 API Key。
用测试批次核对字段、状态和失败重试。
切到正式额度,按批次或监测计划计费。
GET STARTED
支持企业系统、服务商后台、内容平台和数据看板接入;OEM 与私有化另行评估。
PARTNER PROGRAM
面向代理商、服务商与内容平台开放合作。你负责客户与交付,我们提供诊断工具、监测能力、数据口径和联合支持。
合作按资质与场景评估,权益以协议为准
同一客户可由多方协作,角色与分成按项目约定。
WHY PARTNER
从发现问题到验证效果,客户看到的每个数字都能回到原始回答与引用。
品牌诊断、商品诊断、问题矩阵和竞品识别共用一套采样规则,交付时不用各说各话。
按计划重复执行,跟踪提及率、首位率和引用变化,把一次性报告变成持续服务。
从问题选择、知识库到文章生成与发布登记,优化动作和结果验证留在同一条链路里。
HOW IT WORKS
说明团队、客户类型与计划承接的场景。
确认交付能力、客户来源与数据合规要求。
确定合作模式、额度与支持范围。
用同一套工具与口径服务客户,按项目复盘。
LET'S TALK
不需要先准备完整方案,说明行业、客户规模和希望承接的服务即可。
见位账号
用注册时的手机号或邮箱登录。
登录后可保留账号信息,换设备也能继续使用。
会员套餐
套餐、诊断、发票或账号问题都可以直接问。复杂问题会转给运营同事继续跟进。
AI 回答仅供参考,人工接入后会在这里继续回复。